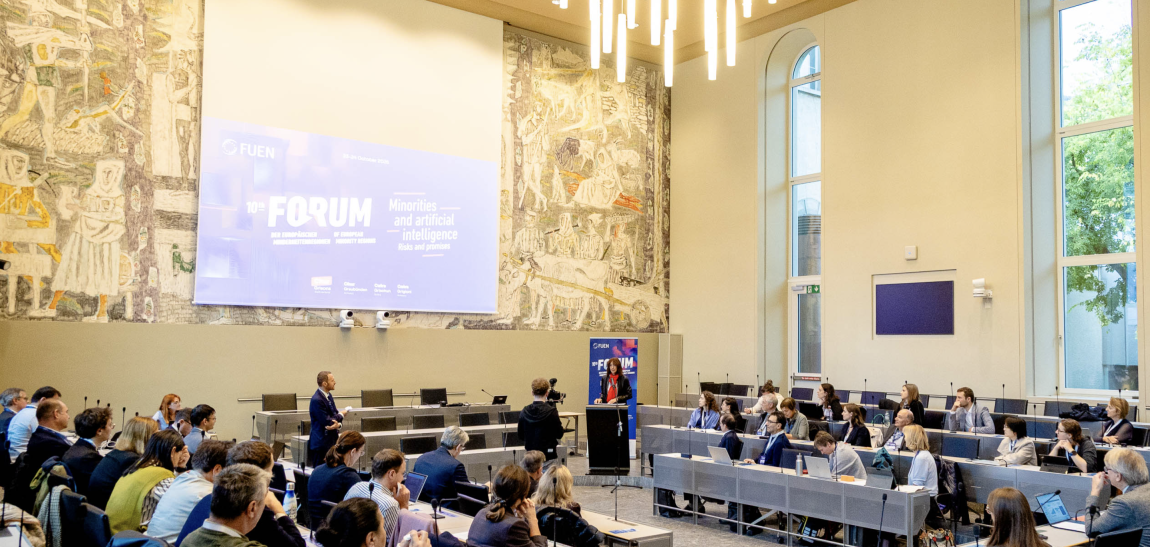
Réunis les 23 et 24 octobre 2026 à Coire, en Suisse, à l'occasion du 10e Forum des régions européennes de minorités organisé par la FUEN, des représentants de minorités linguistiques, des chercheurs et des entreprises technologiques ont présenté les possibilités offertes par l'intelligence artificielle pour préserver et développer leurs langues. Du romanche à l'irlandais, en passant par le ladin, les initiatives se multiplient. Des expériences qui pourraient également inspirer l'avenir numérique du breton.
En ouverture, sa présidente Olivia Schubert a rappelé que la diversité linguistique devait être prise en compte dans les politiques européennes sur l'intelligence artificielle. La FUEN demande notamment que les langues minoritaires soient intégrées aux politiques numériques des États et que leurs communautés participent aux décisions qui les concernent.
Selon Marius Lukosiunas, représentant de l'UNESCO, sur les quelque 7 000 langues parlées dans le monde, seulement 1 000 seraient représentées sur Internet. Pour Martin Bühler, président du gouvernement des Grisons, lorsqu'un outil numérique fonctionne mieux dans une langue dominante, il encourage progressivement les utilisateurs à délaisser leur propre langue.
Le romanche développe ses propres outils numériques
L'organisation Lia Rumantscha a présenté plusieurs réalisations, notamment ClaviRom, un clavier Android adapté au romanche, et ALAS, un système de traduction automatique qui a effectué plus de 460 000 traductions en 178 jours. Ces initiatives illustrent le concept de « souveraineté numérique linguistique » : permettre aux communautés de conserver la maîtrise de leurs ressources linguistiques et des technologies qui les exploitent.
L'irlandais mise sur les technologies vocales
L'Irlande a présenté sa stratégie d'intégration de la langue irlandaise dans les services publics numériques. Neasa Ní Chiaráin a notamment exposé les travaux du projet public ABAIR, consacré à la reconnaissance automatique de la parole et à la synthèse vocale en irlandais. La maîtrise des données linguistiques par les communautés constitue également une priorité.
Le ladin entre dans les smartphones
Le ladin, langue romane parlée notamment dans les Dolomites, bénéficie de plusieurs innovations.Samuel Frontull, chercheur à l'université d'Innsbruck et à l'Institut ladin, a présenté Tradutur, un système de traduction automatique, ainsi que des outils d'intelligence artificielle fonctionnant directement sur les appareils des utilisateurs.
Les entreprises Lenovo et Motorola ont participé à la localisation de plus de 200 000 mots pour une interface de smartphone en ladin. Cette collaboration a également permis de développer LiLa, un modèle de traduction automatique à code ouvert.
En Roumanie, dans le Pays sicule, une équipe développe un assistant conversationnel destiné à aider les locuteurs hongrois dans leurs démarches administratives.
Google présente ses modèles ouverts
Daan van Esch, représentant de Google, a indiqué que les claviers pour smartphones de l'entreprise prennent en charge environ 900 variétés linguistiques. Il a également présenté Gemma, une famille de modèles d'intelligence artificielle à poids ouverts que les chercheurs peuvent adapter à leurs propres corpus linguistiques. Cette approche permet d'envisager des modèles spécialisés dans les langues minoritaires sans devoir développer une intelligence artificielle entièrement à partir de zéro.
Et le breton ?
Les expériences présentées en Suisse trouvent un écho particulier en Bretagne. Plusieurs outils numériques existent déjà pour le breton, notamment Anaouder, un système de reconnaissance vocale permettant de transcrire automatiquement des enregistrements audio et vidéo.
Mais les grands modèles de langage ouvrent d'autres perspectives : assistants conversationnels capables de répondre en breton, traduction contextualisée, outils pédagogiques ou encore recherche documentaire dans des corpus bretons.
Le défi concerne autant la constitution de corpus de qualité que la prise en compte des mutations grammaticales, des variantes dialectales et l'évaluation des résultats par des bretonnants compétents.
Le Pays basque développe son propre modèle de langage
Les projets basques n'étaient pas présentés au colloque. Latxa est un grand modèle de langage (LLM) développé pour le basque par le centre de recherche HiTZ de l'Université du Pays basque. Adapté à partir de modèles ouverts de la famille Llama (Facebook) et entraîné sur un corpus représentant 4,2 milliards de tokens (unités de texte utilisées par les modèles d'IA), Latxa ne se limite pas à la traduction automatique : il vise à comprendre des instructions, produire des textes et dialoguer en euskara.
Rien sur nous sans nous »
En conclusion du forum, le vice-président de la FUEN, Sterică Fudulea, a rappelé le principe : « Rien sur nous sans nous ».
L'intelligence artificielle peut accélérer l'uniformisation linguistique, mais aussi contribuer à revitaliser les langues minoritaires, à condition que leurs locuteurs participent directement au développement des technologies qui les concernent.
Sources :
FUEN, compte rendu du 10e Forum des régions européennes de minorités, 26 octobre 2026 ;
Centre de recherche HiTZ, projet Latxa.

Commentaires (0)
Aucun commentaire pour le moment. Soyez le premier à réagir !